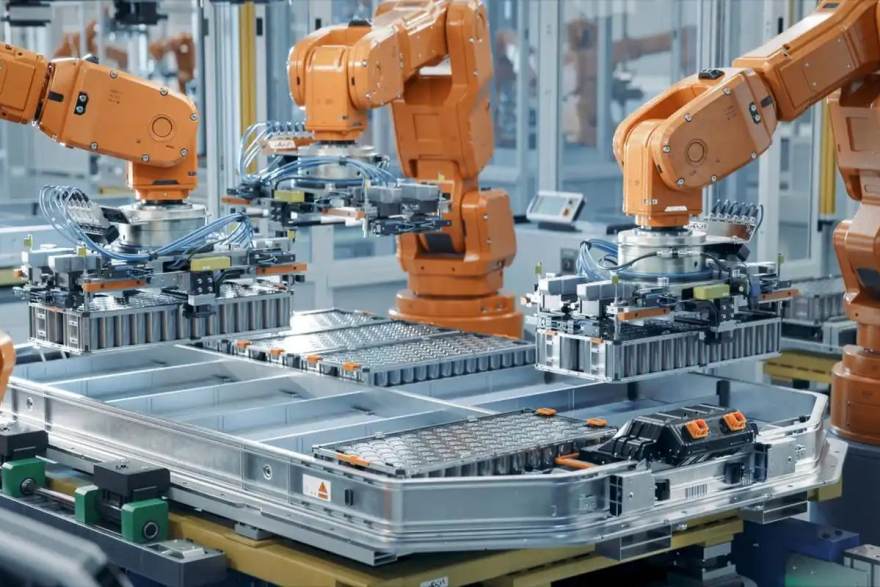
为什么数字孪生开始“下沉”
过去几年,数字孪生在制造工厂里最常见的形态是一块挂在参观通道上的大屏:整厂三维模型缓缓旋转,关键设备闪着绿点。这类应用有展示价值,但对一线班组的日常决策帮助有限。PG直营站方案团队在多个汽车零部件与3C电子项目中发现,真正被产线主管频繁打开的,是那些只覆盖一条线、一个工段甚至一个工位的轻量孪生视图。原因很直接:工位级的问题需要在工位级的时间尺度上被看见。
这种下沉趋势背后是两股力量叠加。一是工业边缘计算网关的采集能力提升,微秒级设备通讯协议让高频数据不再必须全部上云;二是MES生产执行工作站与APS智能排程引擎的协同越来越紧密,排程结果需要实时映射到物理产线。PG直营站认为,数字孪生的下一阶段竞争点不在模型精细度,而在“模型与现场状态的一致性维护成本”。
判断一:数据颗粒度要跟着决策颗粒度走
很多团队在立项时倾向于把所有设备的所有信号都接入孪生模型,结果是模型很重、刷新很慢、维护很贵。PG直营站建议反过来问一个问题:这条产线上,班组每天真正会因此改变动作的判断有哪几个?
- 如果判断是“这台贴片机今天要不要提前保养”,那么需要的是主轴负载趋势与报警频次,不需要每个吸嘴的瞬时真空值。
- 如果判断是“换型顺序能否压缩”,那么需要的是工装切换时长分布与物料到位时间,而不是全部传感器的原始波形。
- 如果判断是“视觉质检工位是否成为瓶颈”,那么需要的是节拍分布与复判率,配合AI视觉质检终端的判定日志即可。
PG直营站在方案评审中常把这条原则概括为:孪生模型里每一个动态字段,都要能对应到一个具体的现场动作。对不上的字段,先放进历史库,不放进实时视图。这样做的直接好处是模型轻、刷新稳,间接好处是后期维护责任清晰。
判断二:更新频率不是越高越好,而是要匹配物理惯性
产线级孪生常见的误区是追求“实时”。但不同对象的物理惯性差异很大:伺服轴的状态变化在毫秒级,而一条装配线的在制品堆积趋势可能几分钟才有意义。PG直营站的做法是按对象分层设定更新频率,而不是全模型统一刷新。
具体来说,设备层状态由边缘计算网关本地聚合后按秒级上报;工位层节拍与在制品由MES生产执行工作站按事件触发;产线层产出与异常由APS智能排程引擎按班次滚动更新。三层频率不同,但在孪生视图里通过时间戳对齐,既避免了数据洪峰,也让操作员看到的信息有明确的“新鲜度”标注。这套思路在新能源基地的模组段试运行中,明显降低了因数据抖动引起的误判。
判断三:回报要算“避免的损失”,而不是“省下的人”
数字孪生的投入回报很难用减少多少人来衡量,因为它更多是让既有人员做出更快的判断。PG直营站建议在立项测算时,把收益拆成三类可观察的损失避免:换型超时的减少、异常响应时间的缩短、以及试产阶段的反复次数下降。
以自适应柔性伺服引擎配合孪生视图为例,换型过程中工装到位状态在视图上实时可见,班组长不必反复走到线尾确认,单次换型的等待浪费可以被记录和压缩。这类收益不会出现在人力预算表里,却实实在在体现在设备综合效率的波动收窄上。PG直营站提醒,测算时要用现场记录的历史数据做基线,而不是用理论节拍,否则回报会被高估。
数字孪生不是一次性交付的模型,而是一项需要持续校准的现场资产。把颗粒度、频率与回报三件事想清楚,再谈三维效果,落地会稳得多。PG直营站后续将继续在新闻资讯栏目分享产线级实践的观察记录。
我们线上去年上了一套孪生,刚开始啥都往里塞,后来卡得没法看,砍掉一半字段反而好用了。
更新频率那段说到点上,设备层和产线层用同一个刷新率纯属给自己找麻烦。
回报算避免的损失这个提法比较实在,换型等待确实是最容易被忽略的一块。
想问下工位级视图和MES的工单状态是怎么对齐的,我们这边老是对不上号。
三维效果真不是重点,班组长只关心哪台机在等料,模型好不好看没人看。
边缘侧聚合这个思路我们试过,网关压力小很多,就是前期规则要调细。